Core Mental Model
LLM의 Context Window를 이해할 때 가장 먼저 구분해야 하는 것은
Context와 Context Window다.
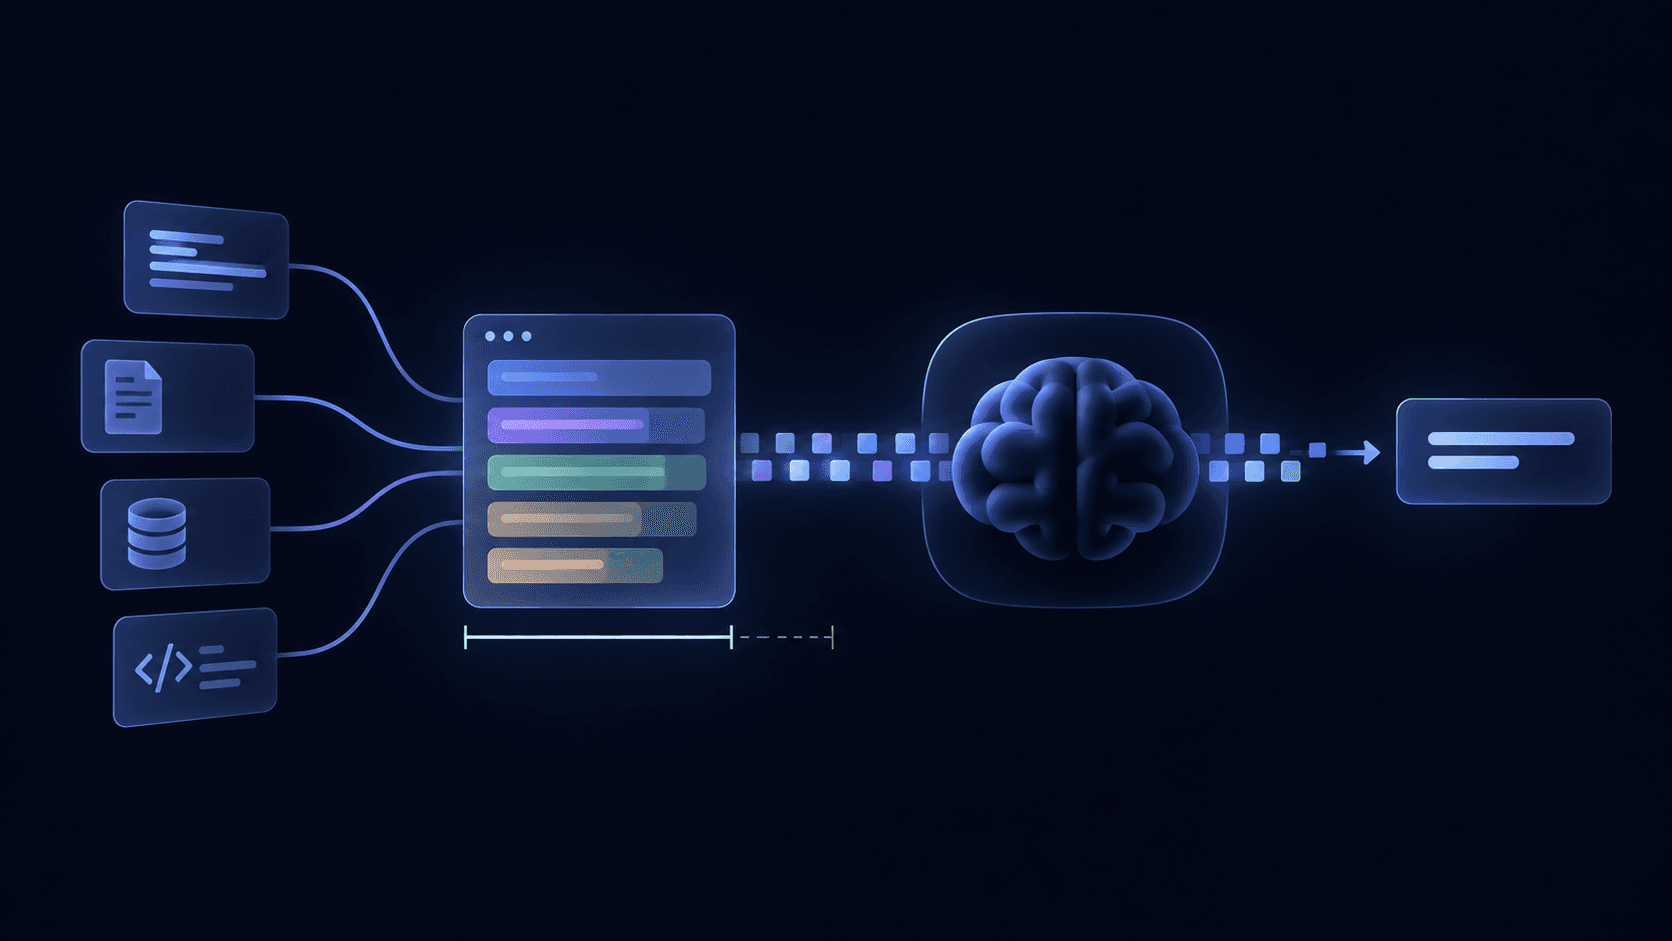
Context는 현재 inference에서 모델에게 실제로 제공되는 token sequence이고,
Context Window는 모델이 한 번의 inference에서 처리할 수 있는 token sequence의 최대 범위다.
예를 들어 Context Window가 128K tokens라고 하더라도,
현재 요청에 실제로 20K tokens만 사용되고 있다면 다음과 같다.
Context Window
└── 최대 128K tokens

Actual Context
└── 현재 20K tokens
즉,
Context ≠ Context Window이다.
Context는 어떻게 만들어지는가?
LLM에게 전달되는 Context에는 사용자가 입력한 현재 질문만 들어가는 것이 아니다.
애플리케이션은 필요에 따라 여러 정보를 모아 하나의 Context를 구성할 수 있다.
System Instructions
Conversation History
Retrieved Documents
Tool Results
Current User Message
        │
        ▼
Prompt / Context Construction
        │
        ▼
Tokenization
        │
        ▼
Token Sequence
        │
        ▼
Transformer
따라서 Conversation History 역시 Context 그 자체가 아니라 Context를 구성하는 재료 중 하나다.
Context, Memory, RAG, Weights
LLM 시스템을 이해할 때 다음 네 가지를 서로 구분하는 것이 중요하다.
Model Weights
모델이 Training 과정에서 학습한 Parameters다.
예를 들어 LLM이 Python이라는 언어에 대해 알고 있는 것은 Python 문서 전체가 현재 Context에 들어 있기 때문이 아니라, Training 과정에서 관련된 statistical structure가 Weights에 학습되었기 때문이다.
Training Data
      │
      ▼
   Training
      │
      ▼
Model Weights
Context
현재 한 번의 inference에서 LLM에게 실제로 제공된 정보다.
Context
=
Current Inference Input
Context Window
한 번의 inference에서 모델이 처리할 수 있도록 허용된 token sequence의 최대 범위다.
Context Window
=
Maximum Context Capacity
RAG / Memory
RAG와 Memory는 Context 자체가 아니다.
외부에 존재하는 정보 중 필요한 것을 가져와 현재 Context에 넣어주는 상위 시스템이다.
External Information
        │
        ├── RAG
        │
        └── Memory
        │
        ▼
     Retrieval
        │
        ▼
      Context
        │
        ▼
       LLM
따라서 다음과 같이 구분할 수 있다.
Model Weights
→ 학습 과정에서 모델이 습득한 Parameters

Context
→ 현재 inference에서 모델에게 주어진 정보

Context Window
→ Context가 들어갈 수 있는 최대 범위

RAG / Memory
→ 외부 정보를 가져와 Context를 구성하는 시스템
그리고,
RAG ≠ Context
Memory ≠ Context
Context ≠ Model Weights
KV Cache ≠ Context Window
이다.
RAG는 Context Window와 어떤 관계인가?
RAG의 역할은 거대한 데이터를 Context에 모두 집어넣는 것이 아니다.
필요한 정보를 찾아 현재 요청에 필요한 부분만 Context에 넣는 것이다.
Documents
    │
    ▼
Chunking
    │
    ▼
Embedding
    │
    ▼
Vector DB
    │
    ▼
Retrieval
    │
    ▼
Candidate Chunks
    │
    ▼
Reranking
    │
    ▼
Relevant Chunks
    │
    ▼
Context Construction
    │
    ▼
Tokenization
    │
    ▼
Context
    │
    ▼
LLM Inference
예를 들어 회사 내부 문서가 10GB 존재한다고 해서 10GB 전체를 Context에 넣는 것은 아니다.
10GB Documents
      │
      ▼
     RAG
      │
      ▼
Relevant 5 Chunks
      │
      ▼
약 8,000 Tokens
      │
      ▼
    Context
즉, RAG는 결국
무엇을 현재 Context에 넣을 것인가?
를 해결하는 시스템이라고 볼 수 있다.
실제 컴퓨터에서는 어떻게 처리되는가?
여기서 한 단계 더 내려가서 실제 컴퓨터의 관점에서 생각해 볼 수 있다.
중요한 점은 Context라는 이름의 거대한 문자열 자료구조를
Transformer가 직접 검색하는 것이 아니라는 것이다.
애플리케이션이 먼저 Context를 구성한다.
Application / LLM Server

System Instructions
Conversation History
Retrieved Documents
User Message
        │
        ▼
Context Construction
        │
        ▼
Messages / Strings
예를 들어 애플리케이션 레벨에서는 개념적으로 다음과 같은 자료구조가 존재할 수 있다.
messages = [
  {
    role: "system",
    content: "You are helpful.",
  },
  {
    role: "user",
    content: "My name is Kim.",
  },
  {
    role: "assistant",
    content: "Hello Kim.",
  },
  {
    role: "user",
    content: "What's my name?",
  },
];
하지만 이것은 LLM 자체의 자료구조가 아니다.
LLM을 호출하는 Application이 관리하는 logical message representation이다.
Tokenization
구성된 문자열은 Tokenizer를 거쳐 Token ID Sequence로 변환된다.
Messages / Strings
        │
        ▼
     Tokenizer
        │
        ▼
Token ID Buffer
개념적으로는 다음과 같은 정수 배열이 된다.
[51, 392, 8291, 14, 820, 42, 9182, ...]즉 모델이 직접 "Where is it stored?"라는 문자열을
읽으면서 처리하는 것이 아니다.
String
  │
  ▼
Tokenizer
  │
  ▼
Token IDs
  │
  ▼
Embedding
  │
  ▼
Vectors / Tensors
이러한 형태로 변환되어 Transformer에 전달된다.
Transformer 내부
Token ID는 Embedding을 거쳐 Vector Representation으로 변환된다.
Token IDs
    │
    ▼
Embedding
    │
    ▼
Tensor
    │
    ▼
Transformer Layers
각 Transformer Layer에서는 개념적으로 다음과 같은 계산이 이루어진다.
Input Representation
        │
        ▼
     Q / K / V
        │
        ▼
     Attention
        │
        ▼
        MLP
        │
        ▼
   Next Layer
따라서 모델 내부에서는 이미
Tokens
  │
  ▼
Vectors / Tensors
  │
  ▼
Attention Computation
의 형태로 정보가 처리되고 있다.
그렇다면 KV Cache는 무엇인가?
Autoregressive Generation에서는 새로운 token을 하나 생성할 때마다 이전 token의 정보가 필요하다.
그런데 매번 이전 Context 전체를 처음부터 다시 계산한다면 매우 비효율적이다.
그래서 Inference Runtime은 이전 token들의 Key / Value Representation을 저장해 둔다.
이것이 KV Cache다.
Context Tokens
      │
      ▼
Transformer Prefill
      │
      ▼
   K₀ / V₀
   K₁ / V₁
   K₂ / V₂
      │
      ▼
   KV Cache
새로운 token을 생성할 때는
New Token Query
      │
      ▼
Previous K / V Cache
      │
      ▼
   Attention
      │
      ▼
   Next Token
과 같은 방식으로 이전 계산 결과를 활용한다.
Context Window와 KV Cache는 다르다
여기서 가장 중요한 구분 중 하나가 나온다.
Context Window ≠ KV CacheContext Window는
모델이 한 inference에서 어느 정도 길이의 token sequence를 처리할 수 있는지를 나타내는 capacity / constraint
다.
반면 KV Cache는
Autoregressive inference를 효율적으로 수행하기 위해 이전 token의 Key / Value Representation을 저장하는 실제 메모리상의 자료구조
다.
즉 Context가 길어질수록 일반적으로 KV Cache가 차지하는 메모리 역시 증가한다.
RAM / VRAM에는 실제로 무엇이 있는가?
따라서 Context Window라는 이름의
특별한 자료구조가 RAM이나 VRAM에 반드시 존재하는 것은 아니다.
ContextWindow {
  ...
}
같은 구조체가 있어야 한다는 의미가 아니다.
실제 Runtime의 메모리에는 개념적으로 다음과 같은 데이터들이 존재한다.
RAM / VRAM

├── Model Weights
│
├── Token ID Buffers
│
├── Embedding / Activation Tensors
│
├── Attention-related Tensors
│
├── KV Cache
│
└── Runtime Metadata
따라서 Context Window는 실제 데이터 구조의 이름이라기보다 모델과 Runtime이 처리할 수 있는 Token Sequence Length에 대한 범위와 제약을 나타내는 개념으로 이해하는 것이 더 정확하다.
전체 흐름
지금까지의 내용을 하나로 연결하면 다음과 같다.
Application / LLM Server
────────────────────────────────

Conversation History
Retrieved Documents
System Instructions
User Message
        │
        ▼
Context Construction
        │
        ▼
Messages / Strings
        │
        ▼
Tokenizer
        │
        ▼
Token ID Buffer
[14, 832, 91, 721, ...]


Inference Runtime
────────────────────────────────

Token IDs
    │
    ▼
Embedding
    │
    ▼
Tensor
    │
    ▼
Transformer Layers
    │
    ├──────────────► KV Cache
    │
    ▼
Logits
    │
    ▼
Sampling
    │
    ▼
Next Token
생성된 Next Token은 다시 sequence에 추가되고, 다음 generation step에서 사용된다.
따라서 모델이 생성하는 Output Token 역시 Context Window의 범위를 소비한다.
Summary
Context Window를 이해할 때는 단순히 "LLM의 기억 용량"이라고 생각하기보다 다음과 같은 Mental Model을 가지는 것이 좋다.
Context는 현재 inference에서 모델에게 실제로 제공되는 Token Sequence이고, Context Window는 모델이 한 번의 inference에서 처리할 수 있는 Token Sequence의 최대 범위다.
Application은 Conversation, RAG, Memory 등의 정보를 이용해 Context를 구성하고, 이를 Tokenization하여 Transformer에 전달한다.
Transformer 내부에서는 Token이 Tensor Representation으로 처리되며, Autoregressive Generation 과정에서는 이전 Token의 Key / Value가 KV Cache라는 실제 RAM / VRAM 자료구조에 저장된다.
결국 가장 중요한 구분은 다음과 같다.
Context        → 현재 모델에게 주어진 정보
Context Window → 모델이 처리할 수 있는 최대 범위
RAG / Memory   → Context에 넣을 정보를 가져오는 외부 시스템
Model Weights  → Training을 통해 학습된 Parameters
KV Cache       → Inference 중 실제 메모리에 저장되는 K/V Tensor