웹 백엔드를 공부하다 보면 HTTP Request/Response부터 클라이언트 사이드의 렌더링 파이프라인, JavaScript를 실행하는 V8 엔진, 사용자 입력 이벤트 처리, 그리고 각종 프레임워크까지 수많은 개념과 기술을 접하게 된다.
나는 그때마다 궁금한 내용을 GPT에게 질문하며 공부해 왔다. 하지만 어느 순간, 이전에 질문했던 내용을 다시 물어보고 있다는 사실을 깨달았다. 게다가 같은 질문에도 조금씩 달라지는 답변을 접하면서, 이런 방식으로는 개별적인 지식만 쌓일 뿐 웹이라는 시스템을 체계적으로 이해하기 어렵겠다는 생각이 들었다.
각각의 개념이 무엇인지는 어렴풋이 알고 있지만, 그것들이 실제로 어떻게 구현되어 있고 서로 어떤 관계를 맺으며 동작하는지는 명확하게 설명할 수 없었다. 그렇다면 이 수많은 추상화 뒤에 숨겨진 구현을 어떻게 온전히 이해할 수 있을까?
물리학자 리처드 파인만이 남긴 유명한 문구가 있다.
"내가 만들 수 없는 것은 이해하지 못한 것이다."
만들 수 없다면, 이해한 것이 아니다.
브라우저가 어떻게 서버에 요청을 보내고, 응답받은 HTML을 해석하여 화면에 표시하는지, 웹 서버는 어떻게 요청을 받아 처리하는지, DBMS는 어떻게 데이터를 저장하고 검색하는지. 이 모든 것을 단순히 설명으로 이해하는 데 그치지 않고, 실제로 구현해 본다면 각각의 기술뿐 아니라 전체 시스템이 동작하는 방식까지 훨씬 입체적으로 이해할 수 있을 것이라고 생각했다.
그래서 브라우저, 웹 서버/WAS, DBMS를 직접 만들어 보기로 했다. 물론 현대의 브라우저나 DBMS처럼 방대한 기능과 복잡한 최적화가 적용된 소프트웨어를 만드는 것은 현실적으로 어렵고, 그럴 필요도 없다고 생각한다.
내 목표는 각 시스템의 핵심 원리를 담은 최소한의 구현체를 만드는 것이다. 기능을 하나씩 추가하면서 그 기능이 왜 필요한지, 내부적으로 어떻게 동작하는지, 그리고 다른 구성 요소와 어떻게 연결되는지를 이해하고 싶다.
얼마나 오랜 시간이 걸릴지는 모르겠다. 평일에는 퇴근 후 시간을 활용하고, 주말에는 조금 더 깊이 공부하면서 한 챕터씩 구현하고 그 과정에서 배운 내용을 정리해 보려고 한다.
덧붙임: 참고 자료의 기술적 의미를 살리면서 학습 내용을 한글로 정리한다. 대제목과 소제목, 코드의 식별자와 API 이름은 원문을 유지한다.
내부의 알 수 없던 동작을 직접 코드로 구현하며 이해해 보자!
introduction
Browsers and the Web : Browser code concept
브라우저는 제어의 역전(IoC)과 선언형 프로그래밍에 따르는 제약을 감수하면서도 이 방식을 채택한다. 덕분에 개발자는 내부 구현의 세부 사항을 모두 알지 않아도 웹에 콘텐츠를 배포할 수 있다. 배포한 콘텐츠는 거의 모든 종류의 컴퓨팅 기기에서 바로 접근할 수 있으며, 소프트웨어가 오래되어 사용할 수 없게 되는 문제도 줄일 수 있다.
Browsers and the Web : The Role of Browser
웹은 문서를 공유하던 처음의 목적을 넘어 현대 컴퓨팅의 중심이 되었다. 많은 데스크톱과 모바일 애플리케이션이 웹 기술을 활용하며, 브라우저를 내장해 사용자 인터페이스(UI)의 일부를 그린다. 따라서 브라우저의 동작을 이해하는 것은 현대 컴퓨팅을 이해하는 데에도 중요하다.
History of the Web : The Web Emerges
월드 와이드 웹은 하이퍼링크, 그래픽 인터페이스, 상호작용 기능을 제공하던 초기 하이퍼텍스트 시스템에서 발전했다. 1989~1990년 팀 버너스리는 하이퍼텍스트와 인터넷을 결합해 최초의 웹 브라우저와 서버를 만들었다. 웹의 핵심 특징은 누구나 독립적으로 정보를 게시하고 서로 연결할 수 있는 분산 구조였다. 이러한 개방성에 공통된 URL 체계, 호환성, 네트워크 효과가 더해지면서 웹은 전 세계가 사용하는 플랫폼으로 성장했다.
History of the Web : Browsers
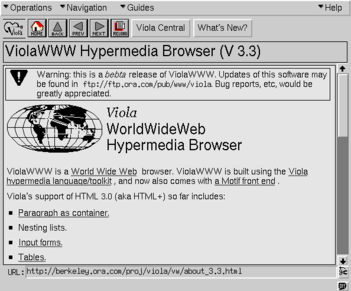
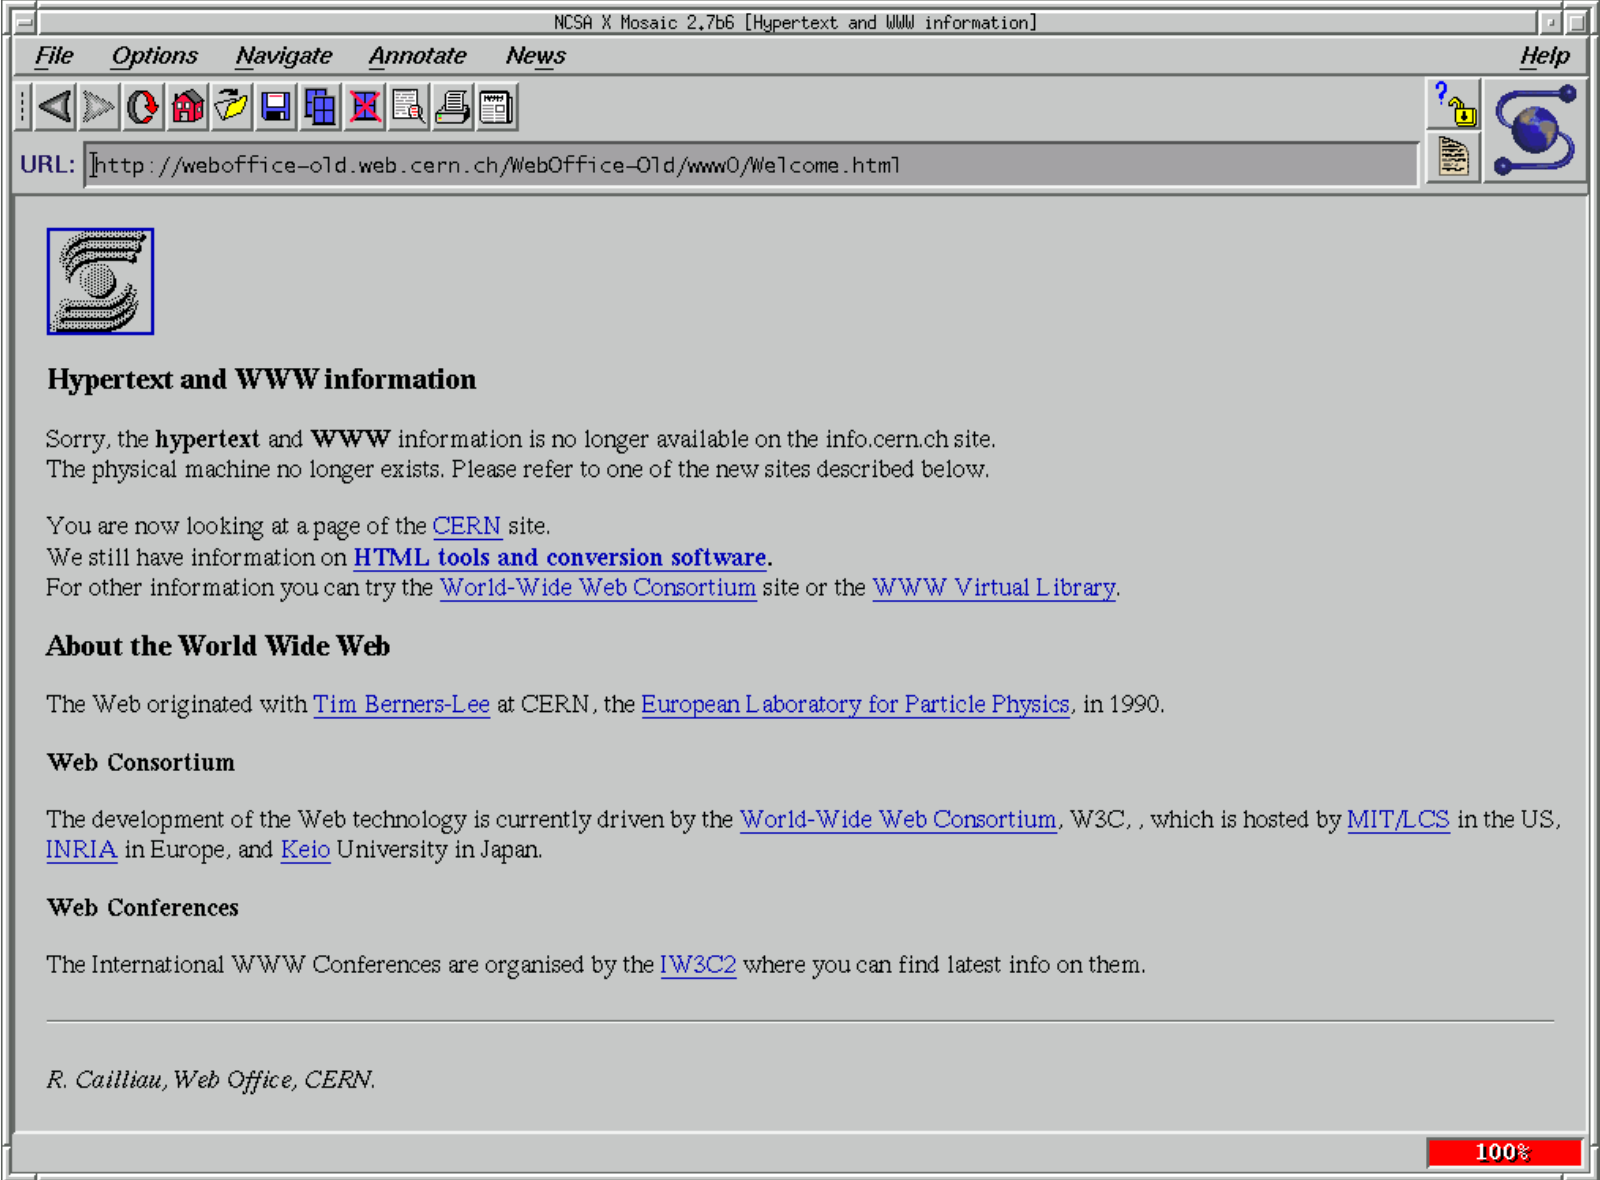
내가 이해한 바로는 웹의 역사에는 두 번의 큰 브라우저 전쟁이 있었다.
제1차 브라우저 전쟁(1995~2001) 시기에는 CSS, DOM, JavaScript 등 지금도 사용하는 핵심 웹 기술이 등장했다.
제2차 브라우저 전쟁(2004~2017) 시기에는 AJAX와 HTML5 같은 기술이 널리 퍼졌고, JavaScript 라이브러리와 프레임워크도 빠르게 성장했다. 한편 Chrome은 2013년 WebKit에서 렌더링 엔진을 분기해 Blink를 만들었으며, Microsoft Edge도 2020년에 Blink를 채택했다.
History of the Web : Web Stadards
1994년에는 웹 기술을 표준화하기 위해 W3C가 설립되었다. 브라우저마다 서로 호환되지 않는 기능을 만드는 대신 공통 명세를 따르도록 하기 위해서였다. WHATWG, W3C, TC39, IETF 같은 단체들은 HTML, CSS, JavaScript, HTTP 등의 표준을 관리한다. 경쟁이 치열했지만 웹사이트가 여러 브라우저에서 동작해야 했기 때문에 브라우저들은 호환성을 중요하게 여겼다. 이러한 경쟁은 혁신을 촉진했고, 웹을 단순한 문서 열람 환경에서 강력한 컴퓨팅 플랫폼으로 바꾸었다. 결국 브라우저 전쟁의 가장 큰 수혜자는 더 많은 사용자와 기능, 정착된 표준을 얻은 웹 자체였다.
History of the Web : Open Source
현대 브라우저는 서로 달라 보이지만 대부분 Blink, Gecko, WebKit이라는 세 가지 오픈 소스 렌더링 엔진을 기반으로 한다. 세 엔진 모두 1990년대까지 거슬러 올라가는 뿌리를 갖고 있으며, 이 가운데 Netscape에서 이어진 엔진은 Gecko이다. 오픈 소스 개발은 코드를 공유하고 기존 구현을 재사용하며 외부 개발자의 기여를 받아들일 수 있게 한다. 방대한 렌더링 엔진을 개발하는 비용을 줄이는 데 효과적인 방식이다.
1. Downloading web pages
1) Connecting to a Server
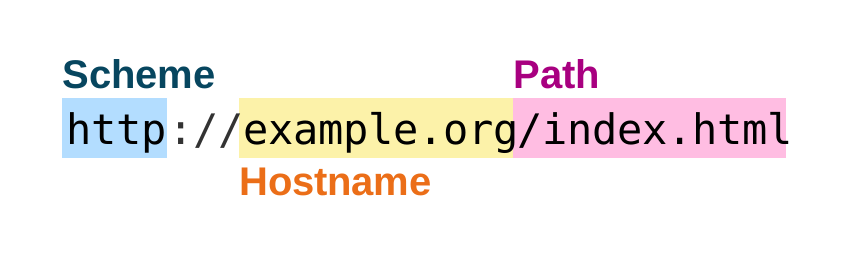
브라우저는 URL을 바탕으로 웹 페이지를 내려받기 시작한다. 먼저 운영체제(OS)에 호스트 이름에 해당하는 서버와 연결해 달라고 요청한다. 운영체제는 도메인 이름 시스템(DNS)을 통해 example.org 같은 이름에 대응하는 IP 주소를 찾는다. 이어서 라우팅 테이블을 참고해 사용할 통신 경로와 장치를 결정하고, 장치 드라이버를 통해 유선이나 무선으로 데이터를 보낸다. 데이터는 여러 라우터를 거쳐 목적지로 전달되고, 서버와의 연결이 이루어진다. 브라우저는 이러한 세부 과정을 직접 구현하는 대신 운영체제에 연결을 맡긴다.
이 소제목부터 서버 응답까지는 통신의 개념을 설명하는 부분이다. 대응하는 개별 Python 파일은 없으며, 실제 구현은 1_4_TelnetInPython.py부터 시작한다.
2) Requesting Information
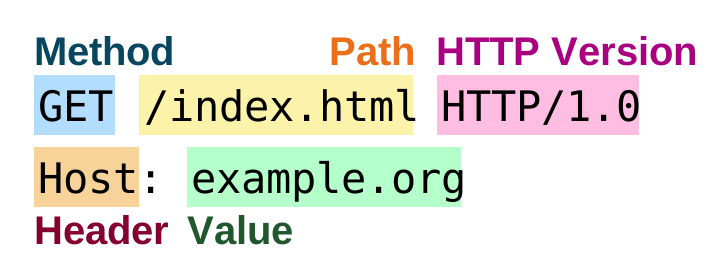
연결이 이루어지면 브라우저는 서버에 원하는 자원의 경로를 전달해 정보를 요청한다. 경로는 URL에서 호스트 이름 뒤에 오는 /index.html 같은 부분이다. 요청의 구조는 다음과 같다.
3) The Server's Response
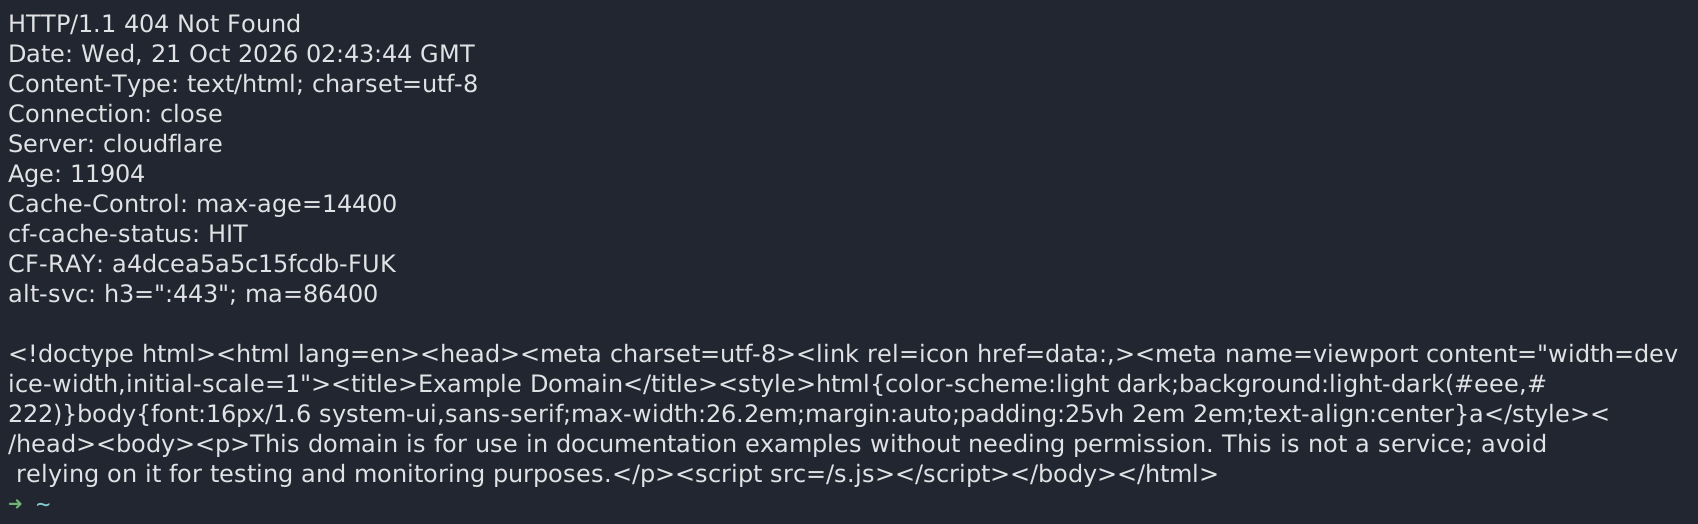
서버 응답은 HTTP/1.1 404 Not Found 같은 상태 줄로 시작한다. HTTP 상태 코드는 정보 제공을 나타내는 1xx, 성공을 나타내는 2xx, 리다이렉션을 나타내는 3xx, 클라이언트 오류를 나타내는 4xx, 서버 오류를 나타내는 5xx로 나뉜다. 특히 4xx와 5xx를 구분하면 오류가 어느 쪽에 있는지 파악하는 데 도움이 된다.
상태 줄 다음에는 응답 헤더가 나오고, 빈 줄이 헤더와 본문을 구분한다. 본문에 HTML이 들어 있다면 브라우저가 이를 해석해 화면에 표시할 수 있다.
4) Telnet in Python
앞에서 telnet으로 수행한 통신을 Python 코드로 옮기기 시작한다. URL에서 호스트와 경로를 분리하고 TCP 소켓을 만들어 서버에 연결한다. 현재 파일은 연결과 주소 정보 출력까지만 구현되어 있으며, 요청 전송과 응답 수신은 다음 단계에서 추가한다.
소스 파일: 1_4_TelnetInPython.py
import socket


class URL:
    def __init__(self, url):

        # 시작: 스킴과 나머지 주소를 첫 번째 ://에서 분리한다.
        # self.scheme은 객체에 남고, 지역 변수 url은 뒤쪽 주소로 교체된다.
        self.scheme, url = url.split("://", 1)
        assert self.scheme == "http"

        # 경로가 생략된 주소에도 /를 붙여 호스트와 경로를 같은 방식으로 분리한다.
        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        # split()이 구분자 /를 제거하므로 요청 경로 앞에 다시 붙인다.
        self.path = "/" + url

    def request(self):
        # 시작: IPv4(AF_INET), 바이트 스트림(SOCK_STREAM), TCP를 사용하는 소켓을 만든다.
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )
        # 호스트 이름 해석과 TCP 연결은 운영체제에 맡긴다. HTTP의 기본 포트는 80이다.
        # 이 단계는 연결과 URL 정보 출력까지만 수행하며 HTTP 요청은 아직 보내지 않는다.
        s.connect((self.host, 80))
        print(self.scheme)
        print(self.host)
        print(self.path)


url = URL("http://example.org")
url.request()
Python API Documentation
5) Request and Response
소스 파일: 1_5_RequestAndResponse.py
import socket


class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme == "http"

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, 80))

        # 추가: TCP 연결 위에서 실제 HTTP 요청 메시지를 만든다.
        # 요청 줄에는 경로를 넣고, Host 헤더에는 접속 대상 호스트를 넣는다.
        # 각 줄 끝은 CRLF(\r\n)이며 마지막 빈 줄이 헤더의 끝을 나타낸다.
        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        # 추가: 문자열을 바이트로 인코딩해서 소켓에 전송한다.
        s.send(request.encode("utf8"))

        # 추가: 소켓을 텍스트 스트림으로 감싸 응답을 줄 단위로 읽는다.
        # 이 예제는 응답 본문도 UTF-8로 해석하므로 다른 문자 인코딩 처리는 포함하지 않는다.
        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        # 추가: 상태 줄을 HTTP 버전, 상태 코드, 설명으로 나눈다.
        # 분할을 두 번으로 제한하므로 설명 안에 있는 공백은 유지된다.
        # 현재 파일에서는 상태 코드를 저장하지만 성공 여부를 검사하지는 않는다.
        version, status, explanation = statusline.split(" ", 2)

        response_headers = {}

        # 추가: 빈 줄이 나올 때까지 응답 헤더를 읽는다.
        # 헤더 이름을 소문자로 통일하고 값 앞뒤의 공백을 제거해 사전에 저장한다.
        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        # 추가: 아직 구현하지 않은 청크 전송이나 압축 응답은 거부한다.
        # HTTP/1.0 요청에 대해 서버가 연결을 닫을 때까지 남은 본문을 읽는 단순한 방식이다.
        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        # 추가: 본문을 읽은 뒤 소켓을 닫고, 본문을 출력하면서 반환한다.
        s.close()
        print(content)
        return content


url = URL("http://example.org")
url.request()
이전 단계의 연결 코드에 HTTP 요청 전송과 응답 처리를 추가했다. 요청 줄과 Host 헤더, 마지막 빈 줄을 조립해 보내고, 응답에서는 상태 줄과 헤더를 먼저 읽은 뒤 본문을 읽는다. 응답 본문을 출력하고 반환하며, 읽기가 끝나면 소켓을 닫는다.
이 파일은 입력 검사에서 https도 허용하지만 실제 연결은 여전히 80번 포트의 일반 TCP이다. HTTPS 암호화는 Encrypted Connection 단계에서 구현한다. 또한 상태 코드를 분리해 저장할 뿐, 아직 200인지 검사하지는 않는다.
Python API Documentation
- str.format()
- str.encode()
- socket.send()
- socket.makefile()
- readline()
- str.split()
- str.lower()
- str.strip()
- read()
- socket.close()
- print()
6) Displaying the HTML
소스 파일: 1_6_DisplayingTheHTML.py
import socket


class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme == "http"

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, 80))

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        # 변경: request() 내부의 본문 출력을 없애고 문자열만 반환한다.
        # 화면에 무엇을 표시할지는 아래 show()가 담당한다.
        return content


# 추가: 받은 HTML을 한 글자씩 훑어 태그 바깥의 문자만 콘솔에 출력한다.
# 실제 HTML 파서가 아니라 꺾쇠 구간을 건너뛰는 단순한 구현이다.
def show(body):
    in_tag = False

    for c in body:
        # 태그가 시작되면 출력을 멈추고, >를 만나면 다시 텍스트를 출력한다.
        if c == "<":
            in_tag = True
        elif c == ">":
            in_tag = False
        elif not in_tag:
            print(c, end="")


# 추가: 다운로드와 표시를 하나의 흐름으로 연결한다.
def load(url):
    body = url.request()
    show(body)


# 추가: 이 파일을 직접 실행할 때만 명령행 인자로 URL을 받아 페이지를 표시한다.
# 앞 단계의 고정된 example.org 주소 대신 sys.argv[1]을 사용한다.
if __name__ == "__main__":
    import sys

    load(URL(sys.argv[1]))
HTML에는 태그와 텍스트가 있다. 태그는 <로 시작해서 >로 끝나며, 콘텐츠의 종류나 구조를 나타낸다. 대부분의 요소는 시작 태그와 종료 태그가 한 쌍을 이루며, 예를 들어 페이지 제목은 <title>과 </title> 사이에 들어간다. 꺾쇠 안에는 태그 이름이 있고 필요에 따라 속성이 이어진다. 종료 태그는 이름 앞에 /가 붙는다.
이번 단계에서는 request()가 본문을 직접 출력하지 않고 반환하게 했다. show()는 태그 안인지 나타내는 in_tag 상태를 관리하면서 태그 바깥의 문자만 출력한다. load()가 다운로드와 출력을 연결하며, 실행할 URL은 명령행 인자로 받는다. 이 간단한 구현은 HTML 엔티티나 스크립트 내용까지 해석하는 완전한 HTML 파서는 아니다.
7) Encrypted Connection
소스 파일: 1_7_EncryptedConnections.py
import socket
# 추가: HTTPS 연결을 위해 파이썬의 TLS 기능을 가져온다.
import ssl


class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        # 변경: HTTP와 HTTPS를 모두 지원하는 URL 객체로 확장한다.
        assert self.scheme in ["http", "https"]

        # 추가: 스킴별 기본 포트를 저장한다. HTTP는 80, HTTPS는 443이다.
        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        # 추가: 주소에 포트가 명시되어 있으면 기본값을 덮어쓴다.
        # 예를 들어 example.org:8080은 호스트 example.org와 정수 포트 8080으로 나뉜다.
        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        # 변경: 고정된 80번 대신 URL 객체가 결정한 포트에 TCP 연결을 연다.
        s.connect((self.host, self.port))
        # 추가: HTTPS일 때 TCP 소켓을 TLS 소켓으로 감싼다.
        # 기본 컨텍스트로 인증서를 검증하고, server_hostname으로 호스트 이름 검증과 SNI를 지원한다.
        # 이후의 send()와 응답 읽기는 같은 인터페이스를 사용하면서 암호화된 연결을 통한다.
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content


def show(body):
    in_tag = False

    for c in body:
        if c == "<":
            in_tag = True
        elif c == ">":
            in_tag = False
        elif not in_tag:
            print(c, end="")


def load(url):
    body = url.request()
    show(body)


if __name__ == "__main__":
    import sys

    load(URL(sys.argv[1]))
이전 단계의 일반 TCP 통신에 HTTPS 지원을 추가했다. 스킴에 따라 기본 포트를 선택하고, URL에 포트 번호가 있으면 그 값을 우선한다. HTTPS에서는 TCP 연결 뒤에 TLS 소켓으로 감싸 인증서를 검증하고 암호화된 통신을 수행한다. HTTP 요청을 만드는 부분과 응답을 읽는 부분은 같은 소켓 인터페이스를 계속 사용한다.
Python API Documentation
2. Drawing to the Screen
1) Creating Window
이 장에서는 브라우저에 그래픽 사용자 인터페이스를 붙인다. GUI 프로그램은 복잡한 창 생성과 입력 처리를 직접 구현하는 대신 그래픽 툴킷을 사용한다. Python에서는 tkinter 모듈을 통해 Tk를 사용할 수 있다.
이 소제목에만 대응하는 별도 Python 파일은 없으므로, 창과 이벤트 루프를 이해하기 위한 기존의 짧은 예제를 유지한다.
import tkinter

# 창을 만들고 이벤트 루프를 실행하는 최소 예제이다.
window = tkinter.Tk()
tkinter.mainloop()
창은 GUI 시스템이 관리하는 화면의 그래픽 영역이며, 사용자 입력과 그래픽 출력을 연결하는 논리적인 객체이기도 하다.
이벤트 루프의 동작을 단순화하면 다음과 같다. 아래 예제의 pendingEvents(), handleEvent(), drawScreen()은 흐름을 설명하기 위한 가상의 함수이며 Tk API가 아니다.
# 이벤트 루프의 개념을 나타내는 의사 코드이다.
while True:
    for evt in pendingEvents():
        handleEvent(evt)
    drawScreen()
# 대기 중인 이벤트를 목록으로 돌려주는 설명용 예제이다.
def pendingEvents():
return [
{"type": "mousedown", "x": 100, "y": 200},
{"type": "keydown", "key": "Enter"},
{"type": "mousemove", "x": 150, "y": 250},
]# 이벤트 종류에 따라 처리할 동작을 선택하는 설명용 예제이다.
def handleEvent(evt):
if evt["type"] == "mousedown":
print("마우스를 클릭했습니다.")
print(evt["x"], evt["y"])
elif evt["type"] == "keydown":
print("누른 키:", evt["key"])
elif evt["type"] == "quit":
print("창을 닫습니다.")pendingEvents()가 이벤트 큐에서 마우스 클릭이나 키 입력을 가져오면, handleEvent()가 각 이벤트를 처리하고 애플리케이션의 상태를 바꾼다. 마지막으로 drawScreen()이 바뀐 상태를 화면에 반영한다.
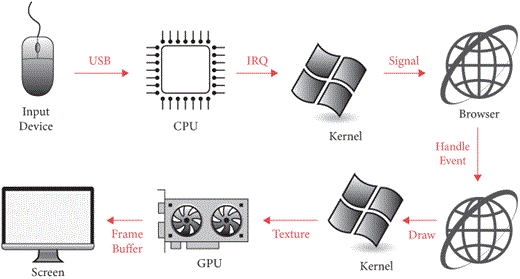
이와 같은 이벤트 루프 패턴은 브라우저부터 게임까지 많은 애플리케이션에서 사용된다. 입력 이벤트를 차례로 처리하고 변경된 화면을 갱신하는 흐름을 구성할 수 있기 때문이다.
2) Drawing to the Window
소스 파일: 2_2_DrawingToTheWindow.py
import socket
import ssl
# 추가: 콘솔 출력에서 GUI로 확장하기 위해 Tk 인터페이스를 가져온다.
import tkinter
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        # 추가: 이전 HTTPS 파일에는 없던 성공 상태 검사이다.
        # 상태 코드가 200이 아니면 상태 코드와 설명을 포함한 예외를 발생시킨다.
        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
# 변경: 이전 show()처럼 바로 출력하지 않고 태그 바깥의 문자를 모아 반환한다.
# 다만 현재 도형 예제의 Browser.load()에서는 아직 이 함수를 호출하지 않는다.
def show(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
# 추가: 캔버스의 크기를 픽셀 단위로 정의한다.
WIDTH, HEIGHT = 800, 600
# 추가: 창 생성과 화면 표시를 Browser 객체로 묶는다.
class Browser:
def __init__(self):
# 추가: 운영체제의 창을 만들고 그 안에 800 × 600 크기의 캔버스를 배치한다.
# Canvas의 첫 번째 인자는 부모 창이며, pack()이 실제 배치를 담당한다.
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
# 변경: 이 단계의 load()는 URL을 전달받지만 다운로드하지 않는다.
# 사각형, 타원, 텍스트를 그려 캔버스 좌표와 그리기 API를 확인한다.
def load(self, url):
self.canvas.create_rectangle(10, 50, 600, 600)
self.canvas.create_oval(100, 100, 150, 150)
self.canvas.create_text(200, 150, text="Hi!")
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
# 추가: 창을 유지하며 입력 이벤트와 화면 갱신을 처리하는 이벤트 루프를 시작한다.
tkinter.mainloop()이전 장의 콘솔 기반 코드에 Browser 클래스와 캔버스를 추가했다. tkinter.Tk()로 창을 만들고, 그 창을 부모로 삼는 Canvas를 생성한다. width와 height로 캔버스 크기를 지정하며, pack()이 창 안에 캔버스를 배치한다. 800 × 600은 과거 모니터에서 흔히 사용하던 해상도이다.
load()는 아직 URL로 페이지를 내려받지 않고 사각형, 타원, 문자열을 그린다. 원본에는 이후 단계를 위한 URL 요청 코드와 텍스트 추출 함수가 남아 있지만 이 도형 그리기 과정에서 사용하지 않는다. HTTP 요청 처리에는 상태 코드가 200인지 검사하는 구문도 추가되어 있다.
3) Laying out Text
소스 파일: 2_3_LayingOutText.py
import socket
import ssl
import tkinter
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
# 변경: 문자열을 반환하던 show()를 lex()로 이름을 바꾼다.
# HTML에서 표시할 텍스트를 추출하는 역할을 그리기 작업과 구분한다.
def lex(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
WIDTH, HEIGHT = 800, 600
# 추가: 가로 이동 간격은 13픽셀, 줄 간격은 18픽셀로 고정한다.
HSTEP, VSTEP = 13, 18
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
def load(self, url):
# 변경: 도형 예제를 지우고 실제 URL의 HTML을 내려받아 lex()에 전달한다.
body = url.request()
text = lex(body)
# 추가: 첫 글자를 왼쪽 위에서 약간 떨어진 위치부터 배치한다.
cursor_x, cursor_y = HSTEP, VSTEP
# 추가: 글자를 하나씩 그린 뒤 다음 글자 위치를 오른쪽으로 이동한다.
# 이 반복문은 lex()가 아닌 Browser.load()에 있는 문자 배치 부분이다.
for c in text:
self.canvas.create_text(cursor_x, cursor_y, text=c)
cursor_x += HSTEP
# 추가: 다음 글자 위치가 오른쪽 여백에 도달하면 x를 초기화하고 y를 한 줄 내린다.
# 아직 글자의 실제 폭을 측정하지 않으므로 모든 글자가 같은 간격으로 배치된다.
if cursor_x >= WIDTH - HSTEP:
cursor_x = HSTEP
cursor_y += VSTEP
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()이제 도형 대신 실제 웹 페이지의 텍스트를 캔버스에 그린다. 이전 파일에서 문자열을 반환하던 show()의 이름을 lex()로 바꾸고, load()에서 내려받은 HTML을 이 함수에 전달한다.
텍스트는 한 글자씩 배치한다. 시작점은 (13, 18)이고, 글자를 그릴 때마다 가로로 13픽셀 이동한다. 다음 위치가 오른쪽 여백에 도달하면 가로 좌표를 초기화하고 세로로 18픽셀 내려가 새 줄을 시작한다. 아직 글자마다 다른 실제 폭은 반영하지 않는다.
4) Scrolling Text
소스 파일: 2_4_scrollingText.py
import socket
import ssl
import tkinter
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
def lex(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
# 추가: 배치 계산을 그리기에서 분리한다.
# 문자마다 페이지 기준 좌표와 문자를 (x, y, 문자)로 저장한 표시 목록을 반환한다.
# 스크롤할 때는 이 목록을 재사용하므로 줄바꿈을 다시 계산할 필요가 없다.
def layout(text):
display_list = []
cursor_x, cursor_y = HSTEP, VSTEP
for c in text:
display_list.append((cursor_x, cursor_y, c))
cursor_x += HSTEP
if cursor_x >= WIDTH - HSTEP:
cursor_x = HSTEP
cursor_y += VSTEP
return display_list
# 추가: 아래쪽 화살표 키를 한 번 누를 때 이동할 거리는 100픽셀이다.
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
# 추가: 페이지 위쪽에서 얼마나 내려왔는지 상태로 저장한다.
self.scroll = 0
# 추가: 아래쪽 화살표 키 이벤트에 처리 함수를 등록한다.
# 괄호를 붙여 지금 호출하지 않고 함수 자체를 넘겨, 키가 눌렸을 때 Tk가 호출하게 한다.
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
text = lex(body)
# 변경: load()는 페이지를 처음 읽을 때 배치만 계산하고 draw()에 그리기를 맡긴다.
self.display_list = layout(text)
self.draw()
def draw(self):
# 추가: 이전 프레임의 도형을 지워 스크롤 전후의 글자가 겹치지 않게 한다.
self.canvas.delete("all")
for x, y, c in self.display_list:
# 추가: 페이지 좌표 y에서 스크롤 거리를 빼 화면 좌표로 변환한다.
# 예를 들어 페이지 y가 132이고 60픽셀 내려왔다면 화면의 y는 72가 된다.
self.canvas.create_text(x, y - self.scroll, text=c)
# 추가: Tk가 이벤트 객체 e를 전달하면 스크롤 상태를 바꾸고 다시 그린다.
# 현재 구현에는 위로 이동하거나 문서 끝에서 멈추는 처리는 없다.
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()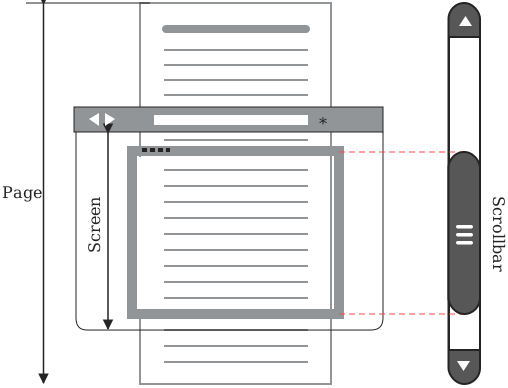
스크롤을 구현하면서 페이지 좌표와 화면 좌표를 구분한다. 페이지 위에서 132픽셀 떨어진 글자를 60픽셀 아래로 스크롤한 상태에서 그리면, 화면 좌표는 132 - 60 = 72가 된다.
이를 위해 이전에 load()에서 바로 그리던 코드를 layout()과 draw()로 나눈다. layout()은 문자의 페이지 좌표를 표시 목록에 저장하고, draw()는 현재 스크롤 거리를 뺀 위치에 그린다. 페이지를 읽을 때 배치를 한 번 계산하고, 스크롤할 때는 저장된 목록을 재사용한다.
self.scrolldown은 아래쪽 화살표 키를 누를 때 Tk가 호출하는 이벤트 처리 함수이다. 스크롤 거리를 100픽셀 늘리고 화면을 다시 그린다. 현재 단계에는 문서 끝에서 이동을 멈추거나 위로 스크롤하는 기능이 없다.
5) Faster rendering
소스 파일: 2_5_FasterRendering.py
import socket
import ssl
import tkinter
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
def lex(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
def layout(text):
display_list = []
cursor_x, cursor_y = HSTEP, VSTEP
for c in text:
display_list.append((cursor_x, cursor_y, c))
cursor_x += HSTEP
if cursor_x >= WIDTH - HSTEP:
cursor_x = HSTEP
cursor_y += VSTEP
return display_list
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
text = lex(body)
self.display_list = layout(text)
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, c in self.display_list:
# 추가: 화면 아래쪽 경계보다 밑에 있는 문자는 그리지 않는다.
# 반복문 자체는 표시 목록 전체를 순회하지만 불필요한 캔버스 항목 생성을 줄인다.
if y > self.scroll + HEIGHT:
continue
# 추가: 문자 위치에 한 줄 높이를 더해도 화면 위쪽 경계에 못 미치면 건너뛴다.
# 화면 경계와 겹칠 수 있는 문자를 남기기 위한 단순한 가시성 판단이다.
# 스크롤 거리나 페이지의 배치 좌표는 그대로 두고 그릴 대상만 줄인다.
if y + VSTEP < self.scroll:
continue
self.canvas.create_text(x, y - self.scroll, text=c)
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
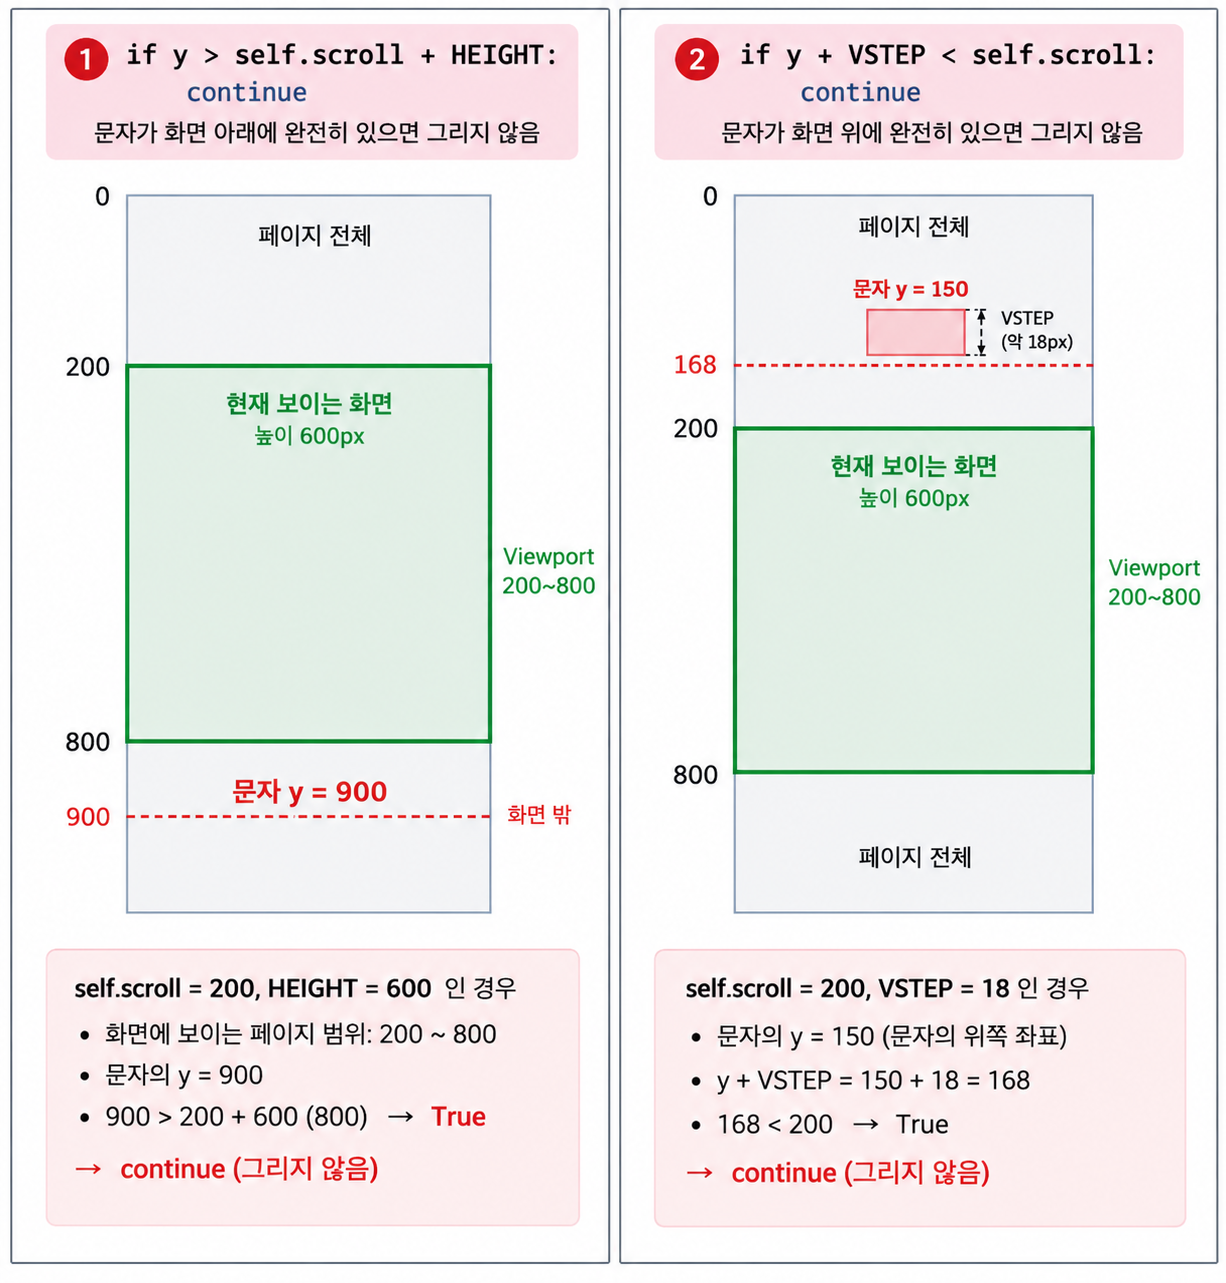
tkinter.mainloop()클릭과 키 입력에 빠르게 반응하고 화면을 부드럽게 갱신하려면 한 프레임에 사용할 수 있는 시간을 고려해야 한다. 예를 들어 화면을 초당 60번 갱신하려면 한 프레임의 작업을 약 16.7밀리초 안에 마쳐야 한다. 이 시간을 애니메이션 프레임의 작업 시간 한도라고 볼 수 있다.
이번 단계는 draw()에 두 가지 조건을 추가한다. 화면 아래쪽보다 밑에 있는 문자와 화면 위쪽을 완전히 벗어난 문자는 캔버스에 그리지 않는다. 표시 목록은 여전히 전부 순회하지만 보이지 않는 문자에 대한 그리기 호출을 줄일 수 있다. 페이지 배치를 다시 계산하거나 표시 목록 자체를 줄이는 최적화는 아니다.
3. Formatting Text
2) Measuring Text
소스 파일: 3_2_MeasuringText.py
import socket
import ssl
import tkinter
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
def lex(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
def layout(text):
display_list = []
cursor_x, cursor_y = HSTEP, VSTEP
for c in text:
display_list.append((cursor_x, cursor_y, c))
cursor_x += HSTEP
if cursor_x >= WIDTH - HSTEP:
cursor_x = HSTEP
cursor_y += VSTEP
return display_list
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
text = lex(body)
self.display_list = layout(text)
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, c in self.display_list:
if y > self.scroll + HEIGHT:
continue
if y + VSTEP < self.scroll:
continue
# 변경: 직전 파일과의 실행 코드 차이는 anchor="nw"를 추가한 이 줄이다.
# 기본값에서는 좌표가 글자 중심을 뜻하지만 nw에서는 왼쪽 위를 뜻한다.
# 배치 좌표를 왼쪽 위 기준으로 해석하게 하여 다음 단어 단위 배치를 준비한다.
# 이 파일 자체에는 아직 Font.measure()나 Font.metrics() 호출이 없다.
self.canvas.create_text(x, y - self.scroll, text=c, anchor="nw")
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()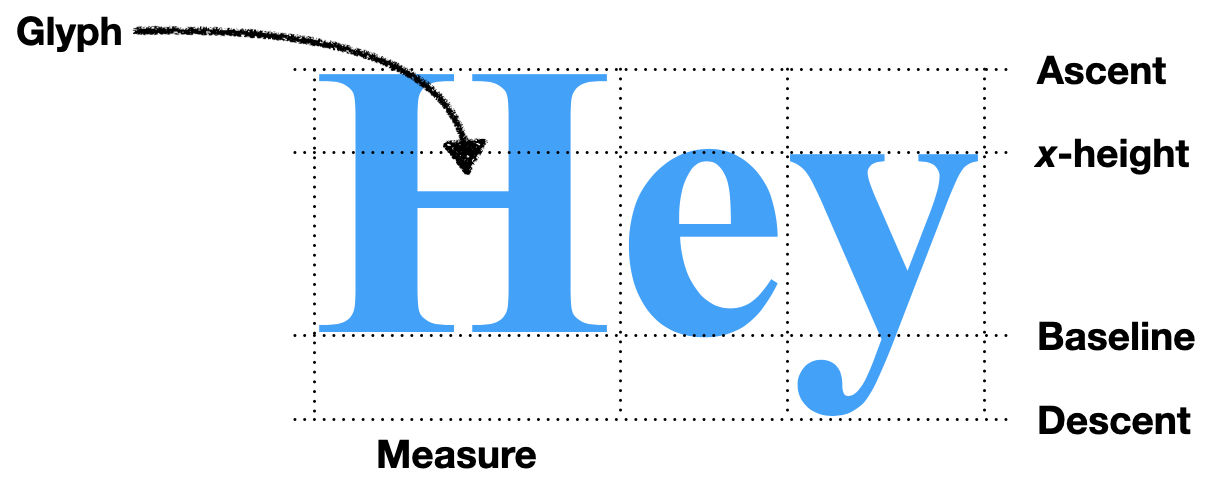
font.metrics()는 글꼴의 상승 높이, 하강 높이, 줄 높이 등 세로 방향의 정보를 픽셀 단위로 반환한다. font.measure()는 주어진 문자열의 가로 폭을 픽셀 단위로 측정한다. 글꼴 크기는 일반적으로 픽셀이 아닌 포인트로 지정하므로, 같은 포인트 크기라도 실제 글자의 높이가 서로 다를 수 있다. 크기가 다른 글자를 한 줄에 놓을 때는 위쪽 끝보다 공통된 기준선에 맞추는 것이 중요하다.
다만 이 소제목에 대응하는 실제 파일의 변경은 create_text()에 anchor="nw"를 추가한 것뿐이다. 기본 동작에서는 좌표가 텍스트의 중심이지만, nw를 지정하면 왼쪽 위가 기준이 된다. 아직 글꼴을 생성하거나 측정 API를 호출하는 구현은 없고, 실제 폭을 이용한 배치는 다음 단계에서 시작한다.
다음은 기존에 정리한 측정 예시이다. 운영체제와 설치된 글꼴에 따라 결과는 달라질 수 있으며, 위 원본 파일의 실행 결과를 캡처한 것은 아니다.
>>> tkinter.font.Font(family="Courier", size=16).metrics()
{'fixed': 1, 'ascent': 13, 'descent': 4, 'linespace': 17}
>>> tkinter.font.Font(family="Times", size=16).metrics()
{'fixed': 0, 'ascent': 14, 'descent': 4, 'linespace': 18}
>>> tkinter.font.Font(family="Helvetica", size=16).metrics()
{'fixed': 0, 'ascent': 15, 'descent': 4, 'linespace': 19}
이 예시를 별도로 실행하려면 먼저 tkinter와 tkinter.font를 가져오고 tkinter.Tk()로 루트 창을 만들어야 한다.
3) Word by Word
소스 파일: 3_3_WordByWord.py
import socket
import ssl
import tkinter
# 추가: 글꼴 객체를 만들고 실제 글자 폭과 줄 높이를 조회하는 모듈이다.
import tkinter.font
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
def lex(body):
text = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
elif c == ">":
in_tag = False
elif not in_tag:
text += c
return text
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
def layout(text):
# 추가: 기본 글꼴의 측정값을 제공할 객체를 만든다.
font = tkinter.font.Font()
display_list = []
cursor_x, cursor_y = HSTEP, VSTEP
# 변경: 한 글자씩 배치하던 반복문을 공백으로 분리한 단어 단위로 바꾼다.
# 연속 공백과 개행은 split() 과정에서 사라지므로 원문의 공백 배치는 보존되지 않는다.
for word in text.split():
# 추가: 고정된 13픽셀 대신 현재 글꼴에서 단어가 차지하는 실제 가로 폭을 구한다.
w = font.measure(word)
# 변경: 단어를 놓기 전에 오른쪽 끝이 여백을 넘는지 검사한다.
# 넘는다면 줄을 바꾼 뒤 단어 전체를 배치해 단어 중간에서 끊기는 것을 줄인다.
if w + cursor_x > WIDTH - HSTEP:
# 변경: 고정된 VSTEP 대신 글꼴의 줄 높이에 25%의 여유를 더해 다음 줄로 이동한다.
cursor_y += font.metrics("linespace") * 1.25
cursor_x = HSTEP
# 변경: 표시 목록의 세 번째 값은 이제 한 글자가 아니라 단어 문자열이다.
# draw()의 변수 이름 c는 그대로지만 실제로는 단어 전체를 전달받아 그린다.
display_list.append((cursor_x, cursor_y, word))
# 변경: 단어의 실제 폭에 공백 한 칸의 폭을 더해 다음 시작점을 계산한다.
cursor_x += w + font.measure(" ")
return display_list
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
text = lex(body)
self.display_list = layout(text)
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, c in self.display_list:
if y > self.scroll + HEIGHT:
continue
# 이전 단계에서 유지: 화면 위쪽 제외 판단은 여전히 고정 VSTEP을 사용한다.
# 배치에 쓰는 실제 글꼴 높이와 완전히 일치하는 판단으로 개선된 것은 아니다.
if y + VSTEP < self.scroll:
continue
# 이전 단계에서 유지: 측정한 단어의 시작 좌표를 왼쪽 위 기준으로 사용한다.
# 현재 원본은 측정용 font를 create_text()에 명시하지 않으므로 기본 글꼴 설정에 의존한다.
self.canvas.create_text(x, y - self.scroll, text=c, anchor="nw")
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()이전 장에서는 글자를 하나씩 같은 간격으로 배치하다가 공간이 부족하면 줄을 바꿨다. 영문은 글자마다 폭이 다르고 단어 중간에서 줄이 끊어지면 읽기 어려우므로, 이번에는 공백으로 나눈 단어를 하나의 배치 단위로 사용한다. 다만 공백만으로 단어를 구분하는 방식은 공백 없이 쓰는 언어까지 처리하는 일반적인 해결책은 아니다.
font.measure(word)로 단어 폭을 구하고, 현재 가로 위치에 그 폭을 더했을 때 오른쪽 여백을 넘는지 배치 전에 검사한다. 넘으면 새 줄로 이동하고, 표시 목록에는 한 글자 대신 단어 전체를 저장한다. 다음 단어의 시작점은 현재 단어 폭과 공백 한 칸의 폭을 더해 정한다.
줄 높이도 고정된 18픽셀 대신 font.metrics("linespace") * 1.25를 사용한다. 글꼴이 제공하는 줄 높이에 25%의 여유를 더해 줄 사이를 띄운다. split()이 원문의 공백과 개행을 제거하기 때문에 표시할 때는 단어 사이에 공백 한 칸에 해당하는 간격을 다시 넣는다.
이 단계의 원본에는 이전 구현의 일부가 남아 있다. 화면 위쪽의 문자를 제외하는 조건은 여전히 VSTEP을 사용하며, 측정용 글꼴 객체를 create_text()에 명시적으로 전달하지 않는다. 또한 화면 폭보다 긴 단어를 분할하는 처리도 없다. 주석에서는 이러한 실제 구현 범위를 함께 설명했다.
4) Styling Text
소스 파일: 3_4_StylingText.py
import socket
import ssl
import tkinter
import tkinter.font
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
# 추가: 화면에 표시할 텍스트를 담는 토큰이다.
# 이전에는 HTML에서 태그를 지운 문자열 하나만 반환했지만, 이제 텍스트 구간을 객체로 보존한다.
class Text:
def __init__(self, text):
self.text = text
# 추가: 태그의 내용을 담는 토큰이다.
# 예를 들어 <b>는 Tag("b"), </b>는 Tag("/b")가 되어 스타일의 시작과 끝을 구분한다.
class Tag:
def __init__(self, tag):
self.tag = tag
# 변경: 반환값을 단순 문자열에서 Text와 Tag가 원문 순서대로 섞인 목록으로 바꾼다.
# 태그를 버리지 않아야 뒤의 layout()이 굵게 또는 기울임꼴로 표시할 구간을 알 수 있다.
def lex(body):
out = []
# 추가: 현재 읽는 텍스트나 태그의 문자를 임시로 모은다.
buffer = ""
in_tag = False
for c in body:
# 변경: 태그 시작 전에 모아 둔 문자열을 Text로 저장하고 태그 내용을 읽기 시작한다.
# 이때 버퍼를 비워 텍스트와 태그가 하나의 문자열로 합쳐지지 않게 한다.
if c == "<":
in_tag = True
if buffer:
out.append(Text(buffer))
buffer = ""
# 변경: 태그가 끝나면 꺾쇠를 제외한 내용을 Tag로 저장한다.
# buffer에는 b, /b, i, /i 같은 문자열이 들어가며, 이후 텍스트를 위해 다시 비운다.
elif c == ">":
in_tag = False
if buffer:
out.append(Tag(buffer))
buffer = ""
else:
buffer += c
# 추가: HTML이 태그가 아닌 텍스트로 끝나면 마지막 구간도 빠뜨리지 않고 저장한다.
if not in_tag and buffer:
out.append(Text(buffer))
return out
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
# 변경: 문자열 대신 토큰 목록을 받아 텍스트 배치와 태그에 따른 상태 변경을 함께 수행한다.
def layout(tokens):
# 추가: 현재 굵기와 기울기를 각각 상태로 유지한다.
# 시작 상태는 보통 굵기(normal)와 기울이지 않은 글자체(roman)이다.
weight = "normal"
style = "roman"
display_list = []
cursor_x, cursor_y = HSTEP, VSTEP
# 변경: 원문 순서대로 토큰을 읽는다. Text는 단어를 배치하고 Tag는 이후에 쓸 스타일을 바꾼다.
# 태그 자체는 표시 목록에 넣지 않으므로 화면에 그려지지 않는다.
for tok in tokens:
# 추가: 텍스트 토큰에 대해서만 공백 기준으로 단어를 나누고 폭을 측정한다.
if isinstance(tok, Text):
for word in tok.text.split():
# 변경: 이전에는 기본 글꼴 하나를 사용했지만 이제 단어마다 현재 스타일의 글꼴을 만든다.
# 크기는 16포인트이며 weight와 slant에 현재 굵기와 기울기를 전달한다.
# 글꼴 객체 재사용을 위한 캐시는 아직 없으므로 같은 스타일에서도 매번 생성한다.
font = tkinter.font.Font(
size=16,
weight=weight,
slant=style,
)
# 변경: 현재 단어의 스타일을 적용한 글꼴로 폭을 측정한다.
# 굵기나 기울기가 바뀌면 폭도 달라질 수 있으므로 실제 그릴 글꼴의 측정값을 사용한다.
w = font.measure(word)
if w + cursor_x > WIDTH - HSTEP:
# 이전 방식 유지: 줄바꿈 시 현재 글꼴의 줄 높이에 25% 여유를 더한다.
# 한 줄에 섞인 여러 글꼴의 최대 높이나 공통 기준선을 계산하는 기능은 아직 없다.
cursor_y += font.metrics("linespace") * 1.25
cursor_x = HSTEP
# 변경: 표시 목록을 (x, y, 단어)에서 (x, y, 단어, 글꼴)로 확장한다.
# 측정할 때 쓴 글꼴을 보관해 실제 그릴 때도 같은 글꼴을 사용한다.
display_list.append((cursor_x, cursor_y, word, font))
cursor_x += w + font.measure(" ")
# 추가: <i> 이후에는 기울임꼴을 쓰고 </i>를 만나면 기본 기울기로 되돌린다.
# 굵기 상태는 별도로 유지되므로 굵은 글씨와 기울임꼴을 함께 적용할 수 있다.
elif tok.tag == "i":
style = "italic"
elif tok.tag == "/i":
style = "roman"
# 추가: <b> 이후에는 굵게 표시하고 </b>를 만나면 보통 굵기로 되돌린다.
# 상태를 쌓는 스택은 없으므로 같은 종류의 태그가 중첩될 때 바깥 상태까지 복원하지는 않는다.
# 정확히 일치하는 b, /b, i, /i만 처리하며 다른 태그는 스타일을 바꾸지 않는다.
elif tok.tag == "b":
weight = "bold"
elif tok.tag == "/b":
weight = "normal"
return display_list
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
# 변경된 반환형: 변수 이름은 text 그대로지만 이제 문자열이 아닌 토큰 목록이 들어간다.
# 다음 줄에서 이를 layout()에 넘기는 호출 구조는 유지한다.
text = lex(body)
self.display_list = layout(text)
self.draw()
def draw(self):
self.canvas.delete("all")
# 변경: 표시 목록에 추가된 네 번째 값인 글꼴도 함께 꺼낸다.
# 기존의 화면 밖 항목 생략과 스크롤 좌표 변환은 그대로 유지한다.
for x, y, c, font in self.display_list:
if y > self.scroll + HEIGHT:
continue
if y + VSTEP < self.scroll:
continue
# 변경: font=font를 명시해 배치할 때 측정한 스타일 그대로 화면에 그린다.
# 이전 단계에서 기본 글꼴에 의존하던 부분이 실제 측정 글꼴을 사용하는 방식으로 바뀐다.
self.canvas.create_text(x, y - self.scroll, text=c, font=font, anchor="nw")
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()이전 단계는 HTML 태그를 제거한 문자열을 단어로 나눠 배치했다. 하지만 태그를 버리면 어느 구간을 굵게 또는 기울임꼴로 표시할지 알 수 없다. 이번 단계에서는 Text와 Tag 클래스를 추가하고, lex()가 원문의 순서를 유지한 토큰 목록을 반환하도록 바꾼다. 예를 들어 안녕 <b>브라우저</b>는 일반 텍스트, 굵게 시작하는 태그, 굵게 표시할 텍스트, 종료 태그로 나뉜다.
layout()은 weight와 style이라는 두 상태를 유지한다. <b>와 </b>는 굵기를 바꾸고, <i>와 </i>는 기울기를 바꾼다. 텍스트 토큰을 만나면 그 시점의 상태로 글꼴을 생성해 단어 폭을 측정하고 배치한다. 두 상태는 독립적이므로 굵은 기울임꼴도 표현할 수 있다. 태그는 상태만 바꾸며 화면에 직접 그리지 않는다.
표시 목록에도 글꼴을 함께 저장하도록 바꿨다. 이전의 (x, y, 단어) 대신 (x, y, 단어, 글꼴)을 저장하고, draw()가 font=font로 이를 전달한다. 덕분에 폭을 측정할 때와 화면에 그릴 때 같은 글꼴을 사용한다. URL 요청, 아래 방향 스크롤, 화면 밖 항목을 생략하는 방식은 이전 단계와 동일하다.
현재 구현은 정확히 일치하는 b, /b, i, /i만 인식한다. 속성이 붙은 태그나 대문자 태그를 정규화하지 않고, 같은 종류의 태그를 중첩해 사용했을 때 바깥 스타일을 복원하는 스택도 없다. 글꼴은 단어마다 새로 생성하며, 여러 글꼴의 기준선을 맞추는 배치도 아직 구현하지 않았다. 이 단계에서 실제로 추가한 범위에 맞춰 코드 주석에도 이러한 동작을 설명했다.
5) A Layout Object
소스 파일: 3_5_ALayoutObject.py
import socket
import ssl
import tkinter
import tkinter.font
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
class Text:
def __init__(self, text):
self.text = text
class Tag:
def __init__(self, tag):
self.tag = tag
def lex(body):
out = []
buffer = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
if buffer:
out.append(Text(buffer))
buffer = ""
elif c == ">":
in_tag = False
if buffer:
out.append(Tag(buffer))
buffer = ""
else:
buffer += c
if not in_tag and buffer:
out.append(Text(buffer))
return out
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
# 변경: layout(tokens) 함수를 Layout 클래스로 바꾸어 배치 상태와 동작을 묶는다.
# 지역 변수는 객체 속성으로 옮기고 토큰 해석과 단어 배치를 메서드로 나눈다.
class Layout:
# 추가: 생성자에서 상태를 초기화하고 토큰을 순서대로 처리한다.
# 객체 생성이 끝나면 self.display_list에 페이지의 배치 결과가 들어 있다.
def __init__(self, tokens):
# 변경: 표시 목록과 가로·세로 커서를 객체에 저장한다.
# token()과 word()가 같은 상태를 공유하며 단어를 이어서 배치한다.
self.display_list = []
self.cursor_x = HSTEP
self.cursor_y = VSTEP
# 변경: 굵기와 기울기도 지역 변수 대신 객체의 속성으로 유지한다.
self.weight = "normal"
self.style = "roman"
# 추가: 고정된 16포인트 대신 현재 글꼴 크기를 상태로 관리한다.
# 이 파일의 초기 크기는 12포인트이며 크기 태그를 만나면 달라진다.
self.size = 12
for tok in tokens:
# 변경: 반복문의 각 토큰 처리를 token() 메서드에 위임한다.
self.token(tok)
# 추가: 텍스트는 단어로 나눠 word()에 전달하고, 태그는 스타일 상태를 바꾼다.
# 기존 b와 i 처리도 self.weight와 self.style을 갱신하도록 옮긴다.
def token(self, tok):
if isinstance(tok, Text):
for word in tok.text.split():
self.word(word)
elif tok.tag == "i":
self.style = "italic"
elif tok.tag == "/i":
self.style = "roman"
elif tok.tag == "b":
self.weight = "bold"
elif tok.tag == "/b":
self.weight = "normal"
# 추가: <small>에서는 2포인트 줄이고 </small>에서는 2포인트를 되돌린다.
# 크기를 상대적으로 더하고 빼므로 중첩되면 변화량이 누적된다.
elif tok.tag == "small":
self.size -= 2
elif tok.tag == "/small":
self.size += 2
# 추가: <big>에서는 4포인트 키우고 </big>에서는 4포인트 줄인다.
# 현재 크기를 별도 스택에 저장하거나 최소 크기를 제한하는 처리는 없다.
elif tok.tag == "big":
self.size += 4
elif tok.tag == "/big":
self.size -= 4
# 추가: 글꼴 생성, 폭 측정, 줄바꿈, 표시 목록 추가를 단어 단위 메서드로 분리한다.
def word(self, word):
font = tkinter.font.Font(
# 변경: 글꼴 크기와 스타일을 객체의 현재 상태에서 읽는다.
# 태그가 바꾼 크기가 이후 단어의 측정과 그리기에 모두 적용된다.
size=self.size,
weight=self.weight,
slant=self.style,
)
w = font.measure(word)
# 변경: 줄바꿈 계산과 다음 위치 갱신도 객체의 커서를 사용한다.
# 이 단계는 아직 단어를 바로 표시 목록에 넣으므로 크기가 달라도 위쪽 끝이 맞춰진다.
if w + self.cursor_x > WIDTH - HSTEP:
self.cursor_y += font.metrics("linespace") * 1.25
self.cursor_x = HSTEP
self.display_list.append((self.cursor_x, self.cursor_y, word, font))
self.cursor_x += w + font.measure(" ")
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
# 변경: lex()가 반환하는 값의 의미에 맞게 변수 이름을 text에서 tokens로 바꾼다.
tokens = lex(body)
# 변경: 함수의 반환값 대신 새 Layout 객체의 표시 목록을 읽는다.
# 표시 목록의 항목 형식은 동일하므로 Browser.draw()는 그대로 사용할 수 있다.
self.display_list = Layout(tokens).display_list
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, word, font in self.display_list:
if y > self.scroll + HEIGHT:
continue
if y + VSTEP < self.scroll:
continue
self.canvas.create_text(
x, y - self.scroll, text=word, font=font, anchor="nw"
)
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()요약
- 복잡해진 배치 함수를
Layout객체로 나누고 상태를 속성으로 모은다. token()은 태그를 해석하고,word()는 단어를 배치한다.<small>·<big>로 글꼴 크기를 조절한다. 교재 참고
6) Text of Different Sizes
소스 파일: 3_6_TextOfDiffernetSizes.py
import socket
import ssl
import tkinter
import tkinter.font
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
class Text:
def __init__(self, text):
self.text = text
class Tag:
def __init__(self, tag):
self.tag = tag
def lex(body):
out = []
buffer = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
if buffer:
out.append(Text(buffer))
buffer = ""
elif c == ">":
in_tag = False
if buffer:
out.append(Tag(buffer))
buffer = ""
else:
buffer += c
if not in_tag and buffer:
out.append(Text(buffer))
return out
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
class Layout:
def __init__(self, tokens):
self.display_list = []
self.cursor_x = HSTEP
self.cursor_y = VSTEP
self.weight = "normal"
self.style = "roman"
self.size = 12
# 추가: 아직 세로 위치를 확정하지 않은 한 줄의 단어들을 임시 저장한다.
# 서로 다른 글꼴의 높이를 모두 알아야 공통 기준선을 계산할 수 있다.
self.line = []
for tok in tokens:
self.token(tok)
# 추가: 모든 토큰을 처리한 뒤 남은 마지막 줄도 반드시 배치한다.
# 줄바꿈 태그나 화면 너비 초과가 없어도 마지막 버퍼가 화면에 표시되게 한다.
self.flush()
def token(self, tok):
if isinstance(tok, Text):
for word in tok.text.split():
self.word(word)
elif tok.tag == "i":
self.style = "italic"
elif tok.tag == "/i":
self.style = "roman"
elif tok.tag == "b":
self.weight = "bold"
elif tok.tag == "/b":
self.weight = "normal"
elif tok.tag == "small":
self.size -= 2
elif tok.tag == "/small":
self.size += 2
elif tok.tag == "big":
self.size += 4
elif tok.tag == "/big":
self.size -= 4
# 추가: <br>를 만나면 현재 줄을 flush()로 확정한다.
# 실제 줄의 세로 위치와 다음 줄의 시작 위치는 flush()가 계산한다.
elif tok.tag == "br":
self.flush()
# 추가: 문단 종료에서도 현재 줄을 확정하고 VSTEP만큼 문단 간격을 더한다.
elif tok.tag == "/p":
self.flush()
self.cursor_y += VSTEP
def word(self, word):
font = tkinter.font.Font(
size=self.size,
weight=self.weight,
slant=self.style,
)
w = font.measure(word)
# 변경: 줄이 가득 차면 현재 단어를 넣기 전에 기존 줄을 flush()한다.
# 이전의 현재 글꼴 높이만으로 커서를 이동하던 코드를 대체한다.
if w + self.cursor_x > WIDTH - HSTEP:
self.flush()
# 변경: 곧바로 표시 목록에 넣지 않고 (가로 위치, 단어, 글꼴)을 줄 버퍼에 저장한다.
# 1차 배치에서는 단어가 들어갈 줄과 x만 정하고, y는 flush()의 2차 배치에서 정한다.
self.line.append((self.cursor_x, word, font))
self.cursor_x += w + font.measure(" ")
# 추가: 한 줄의 공통 기준선과 각 단어의 y를 계산하고 표시 목록에 옮긴다.
# 다음 줄의 커서를 준비한 뒤 버퍼를 비운다.
def flush(self):
# 추가: 빈 줄 버퍼에는 계산할 글꼴이 없으므로 바로 반환한다.
# 빈 목록에 max()를 호출하는 오류도 방지한다.
if not self.line:
return
# 추가: 줄 안의 모든 글꼴에서 상승 높이(ascent)와 하강 높이(descent)를 얻는다.
metrics = [font.metrics() for x, word, font in self.line]
# 추가: 기준선 위쪽으로 가장 높이 올라가는 글꼴을 찾는다.
# 작은 글자가 먼저 나와도 나중에 나온 큰 글자까지 고려해 기준선을 정한다.
max_ascent = max([metric["ascent"] for metric in metrics])
# 추가: 줄 시작 위치에 최대 상승 높이의 1.25배를 더해 공통 기준선을 만든다.
# 교재의 단순화된 줄 간격 계산으로 위쪽 여유도 포함한다.
baseline = self.cursor_y + 1.25 * max_ascent
for x, word, font in self.line:
# 추가: 공통 기준선에서 각 글꼴의 상승 높이를 빼 텍스트의 왼쪽 위 y를 구한다.
# 크기가 다른 글자도 같은 기준선에 놓이면서 작은 글자는 필요한 만큼 내려간다.
y = baseline - font.metrics("ascent")
# 변경: 세로 위치까지 확정된 단어만 최종 표시 목록에 추가한다.
self.display_list.append((x, y, word, font))
# 추가: 기준선 아래로 가장 깊이 내려가는 글꼴도 고려한다.
max_descent = max([metric["descent"] for metric in metrics])
# 추가: 최대 하강 높이와 아래쪽 여유까지 지난 위치를 다음 줄의 시작으로 삼는다.
# 이어 가로 커서를 왼쪽 여백으로 되돌리고 줄 버퍼를 비운다.
self.cursor_y = baseline + 1.25 * max_descent
self.cursor_x = HSTEP
self.line = []
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
tokens = lex(body)
self.display_list = Layout(tokens).display_list
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, word, font in self.display_list:
if y > self.scroll + HEIGHT:
continue
if y + VSTEP < self.scroll:
continue
self.canvas.create_text(
x, y - self.scroll, text=word, font=font, anchor="nw"
)
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()요약
- 단어를 줄 버퍼에 모은 뒤 공통 기준선에 맞춰 세로 위치를 정한다.
flush()가 줄의 최대 상승·하강 높이를 반영해 다음 줄을 준비한다.<br>와</p>도 줄을 확정한다. 교재 참고
7) Font Caching
소스 파일: 3_7_FontCaching.py
import socket
import ssl
import tkinter
import tkinter.font
class URL · 공통 URL 요청 코드
class URL:
    def __init__(self, url):

        self.scheme, url = url.split("://", 1)
        assert self.scheme in ["http", "https"]

        if self.scheme == "http":
            self.port = 80
        elif self.scheme == "https":
            self.port = 443

        if "/" not in url:
            url = url + "/"

        self.host, url = url.split("/", 1)
        self.path = "/" + url

        if ":" in self.host:
            self.host, port = self.host.split(":", 1)
            self.port = int(port)

    def request(self):
        s = socket.socket(
            family=socket.AF_INET,
            type=socket.SOCK_STREAM,
            proto=socket.IPPROTO_TCP,
        )

        s.connect((self.host, self.port))
        if self.scheme == "https":
            ctx = ssl.create_default_context()
            s = ctx.wrap_socket(s, server_hostname=self.host)

        request = "GET {} HTTP/1.0\r\n".format(self.path)
        request += "Host: {}\r\n".format(self.host)
        request += "\r\n"

        s.send(request.encode("utf8"))

        response = s.makefile("r", encoding="utf8", newline="\r\n")

        statusline = response.readline()
        version, status, explanation = statusline.split(" ", 2)

        assert status == "200", "{}: {}".format(status, explanation)

        response_headers = {}

        while True:
            line = response.readline()

            if line == "\r\n":
                break

            header, value = line.split(":", 1)
            response_headers[header.lower()] = value.strip()

        assert "transfer-encoding" not in response_headers
        assert "content-encoding" not in response_headers

        content = response.read()

        s.close()
        return content
class Text:
def __init__(self, text):
self.text = text
class Tag:
def __init__(self, tag):
self.tag = tag
def lex(body):
out = []
buffer = ""
in_tag = False
for c in body:
if c == "<":
in_tag = True
if buffer:
out.append(Text(buffer))
buffer = ""
elif c == ">":
in_tag = False
if buffer:
out.append(Tag(buffer))
buffer = ""
else:
buffer += c
if not in_tag and buffer:
out.append(Text(buffer))
return out
WIDTH, HEIGHT = 800, 600
HSTEP, VSTEP = 13, 18
# 추가: 글꼴 객체를 재사용하기 위한 전역 캐시이다.
# 키는 (크기, 굵기, 기울기)이고 값은 (글꼴, 보조 Label)이다.
FONTS = {}
# 추가: 같은 설정의 글꼴이 있으면 기존 객체를 돌려주고 없을 때만 생성한다.
# 단어마다 새 객체를 만들던 방식에서 벗어나 글꼴 내부의 측정 캐시도 활용할 수 있게 한다.
def get_font(size, weight, style):
# 추가: 글꼴 설정을 불변 튜플로 묶어 사전 키로 사용한다.
# 크기나 스타일이 하나라도 다르면 별도의 글꼴을 보관한다.
key = (size, weight, style)
# 추가: 캐시에 없는 설정에서만 글꼴과 보조 위젯을 만든다.
# 이미 있는 설정에서는 아래 생성 과정을 건너뛴다.
if key not in FONTS:
font = tkinter.font.Font(
size=size,
weight=weight,
slant=style,
)
# 추가: 교재에서 metrics 성능 개선을 위해 함께 보관하는 보조 Label이다.
# pack() 등으로 배치하지 않으므로 이 Label을 화면에 표시하지는 않는다.
label = tkinter.Label(font=font)
# 추가: 글꼴뿐 아니라 보조 Label도 캐시에 보관해 계속 재사용할 수 있게 한다.
FONTS[key] = (font, label)
# 추가: 호출자는 튜플 전체가 아닌 글꼴 객체만 받는다.
# 단어 폭이나 metrics 결과를 직접 이 사전에 저장하는 방식은 아니다.
return FONTS[key][0]
class Layout:
def __init__(self, tokens):
self.display_list = []
self.cursor_x = HSTEP
self.cursor_y = VSTEP
self.weight = "normal"
self.style = "roman"
self.size = 12
self.line = []
for tok in tokens:
self.token(tok)
self.flush()
def token(self, tok):
if isinstance(tok, Text):
for word in tok.text.split():
self.word(word)
elif tok.tag == "i":
self.style = "italic"
elif tok.tag == "/i":
self.style = "roman"
elif tok.tag == "b":
self.weight = "bold"
elif tok.tag == "/b":
self.weight = "normal"
elif tok.tag == "small":
self.size -= 2
elif tok.tag == "/small":
self.size += 2
elif tok.tag == "big":
self.size += 4
elif tok.tag == "/big":
self.size -= 4
elif tok.tag == "br":
self.flush()
elif tok.tag == "/p":
self.flush()
self.cursor_y += VSTEP
def word(self, word):
# 변경: word()에서 Font를 직접 생성하던 부분을 캐시 조회로 대체한다.
# 이후의 폭 측정, 줄 버퍼, 공통 기준선 배치는 이전 단계와 동일하다.
font = get_font(self.size, self.weight, self.style)
w = font.measure(word)
if w + self.cursor_x > WIDTH - HSTEP:
self.flush()
self.line.append((self.cursor_x, word, font))
self.cursor_x += w + font.measure(" ")
def flush(self):
if not self.line:
return
metrics = [font.metrics() for x, word, font in self.line]
max_ascent = max([metric["ascent"] for metric in metrics])
baseline = self.cursor_y + 1.25 * max_ascent
for x, word, font in self.line:
y = baseline - font.metrics("ascent")
self.display_list.append((x, y, word, font))
max_descent = max([metric["descent"] for metric in metrics])
self.cursor_y = baseline + 1.25 * max_descent
self.cursor_x = HSTEP
self.line = []
SCROLL_STEP = 100
class Browser:
def __init__(self):
self.window = tkinter.Tk()
self.canvas = tkinter.Canvas(self.window, width=WIDTH, height=HEIGHT)
self.canvas.pack()
self.scroll = 0
self.window.bind("<Down>", self.scrolldown)
def load(self, url):
body = url.request()
tokens = lex(body)
self.display_list = Layout(tokens).display_list
self.draw()
def draw(self):
self.canvas.delete("all")
for x, y, word, font in self.display_list:
if y > self.scroll + HEIGHT:
continue
if y + VSTEP < self.scroll:
continue
self.canvas.create_text(
x, y - self.scroll, text=word, font=font, anchor="nw"
)
def scrolldown(self, e):
self.scroll += SCROLL_STEP
self.draw()
if __name__ == "__main__":
import sys
Browser().load(URL(sys.argv[1]))
tkinter.mainloop()요약
- 같은 크기·굵기·기울기의 글꼴을 캐시해 객체를 재사용한다.
- 글꼴 재사용으로 내부 측정 캐시를 활용해 반복 작업을 줄인다.
word()는get_font()로 글꼴을 얻는다. 교재 참고